RAG چیست؟ آموزش Retrieval-Augmented Generation با مثال ساده و کاربردی
فرض کنید یک شرکت صدها فایل PDF، مستندات داخلی، قرارداد، دستورالعمل و اطلاعات تخصصی دارد و میخواهد یک Chatbot بسازد که بتواند بر اساس همین اطلاعات به سؤالهای کاربران پاسخ دهد.
آیا کافی است یک مدل زبانی مثل ChatGPT را به آن متصل کنیم؟
خیر.
مدل زبانی بهصورت پیشفرض اطلاعات خصوصی و اختصاصی شرکت شما را نمیداند.
اینجاست که مفهوم RAG وارد میشود.
RAG مخفف:
Retrieval-Augmented Generation
است و یکی از روشهای مهم برای ساخت Applicationهای مبتنی بر LLM است.
در این مقاله میبینیم RAG چیست، چگونه کار میکند، Embedding و Vector Database چه نقشی دارند و چرا RAG با Fine-tuning متفاوت است.
RAG چیست؟
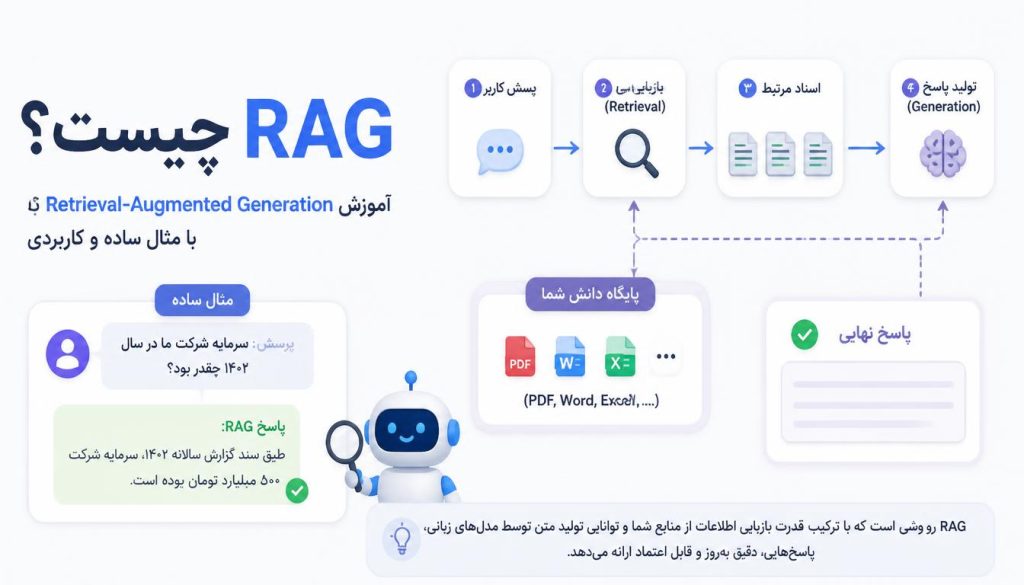
RAG روشی است که در آن قبل از اینکه سؤال کاربر به مدل زبانی داده شود، سیستم اطلاعات مرتبط را از یک منبع داده پیدا میکند و آن اطلاعات را همراه سؤال در اختیار LLM قرار میدهد.
به زبان ساده:
User Question
      ↓
Search Relevant Information
      ↓
Retrieved Documents
      ↓
LLM
      ↓
Answer
یعنی مدل فقط بر اساس دانشی که هنگام Training یاد گرفته پاسخ نمیدهد.
بلکه اطلاعات مرتبط از منابع خارجی نیز در اختیار آن قرار میگیرد.
یک مثال واقعی از RAG
فرض کنید یک شرکت یک سیستم داخلی دارد و تمام مستندات آن در PDF ذخیره شدهاند.
کاربر میپرسد:
سقف تعداد درخواستهای API برای هر مشتری چقدر است؟
LLM بهتنهایی ممکن است جواب این سؤال را نداند.
اما با RAG:
Question
   ↓
Search Company Documents
   ↓
Find relevant section
   ↓
Send section + question to LLM
   ↓
Generate answer
سیستم ابتدا در مستندات شرکت جستجو میکند.
مثلاً بخش زیر پیدا میشود:
Each customer can send a maximum of
10,000 API requests per day.
سپس این اطلاعات همراه سؤال به مدل ارسال میشود.
مدل بر اساس Context دریافتشده پاسخ تولید میکند.
RAG چگونه کار میکند؟
یک سیستم RAG معمولاً چند مرحله دارد.
Documents
   ↓
Chunking
   ↓
Embedding
   ↓
Vector Database
   ↓
User Question
   ↓
Question Embedding
   ↓
Similarity Search
   ↓
Relevant Chunks
   ↓
LLM
   ↓
Answer
حالا هر مرحله را بررسی کنیم.
مرحله اول: جمعآوری اطلاعات
اول باید اطلاعاتی را که قرار است سیستم از آنها استفاده کند آماده کنیم.
مثلاً:
- Word
- صفحات سایت
- Documentation
- Database
- فایلهای متنی
- Knowledge Base
فرض کنید 100 فایل PDF داریم.
این فایلها منبع دانش سیستم RAG خواهند بود.
مرحله دوم: Chunking
معمولاً نمیتوانیم یک فایل بسیار بزرگ را بهصورت کامل برای هر سؤال به مدل ارسال کنیم.
بنابراین Document را به قسمتهای کوچکتر تقسیم میکنیم.
به این قسمتها معمولاً Chunk گفته میشود.
مثلاً:
Document
   ↓
Chunk 1
Chunk 2
Chunk 3
Chunk 4
Chunk 5
فرض کنید یک فایل 50 صفحهای داریم.
سیستم میتواند آن را به بخشهای کوچکتر تقسیم کند تا هنگام جستجو فقط قسمتهای مرتبط پیدا شوند.
مرحله سوم: Embedding چیست؟
Embedding یکی از مفاهیم مهم در سیستمهای RAG است.
Embedding را میتوان بهصورت ساده یک نمایش عددی از معنا یا محتوای یک متن در نظر گرفت.
مثلاً:
"How can I reset my password?"
توسط یک مدل Embedding به یک Vector تبدیل میشود.
مثلاً بهصورت مفهومی:
[0.12, -0.42, 0.81, 0.17, ...]
این Vector نشاندهنده ویژگیهای معنایی متن در فضای embedding است.
هدف این است که متنهایی با مفهوم مشابه، در فضای برداری به یکدیگر نزدیک باشند.
Vector Database چیست؟
حالا که متنها را به Vector تبدیل کردیم، باید جایی برای ذخیره و جستجوی آنها داشته باشیم.
اینجا Vector Database وارد میشود.
مثلاً:
Chunk
   ↓
Embedding
   ↓
Vector Database
Vector Database میتواند هنگام دریافت یک Query، بردارهای مشابه را پیدا کند.
از نمونههای معروف میتوان به:
- Qdrant
- Pinecone
- Weaviate
- Milvus
- pgvector
اشاره کرد.
البته انتخاب Vector Database به معماری پروژه، حجم داده، هزینه و زیرساخت موردنظر بستگی دارد.
مرحله چهارم: سؤال کاربر
حالا کاربر سؤال میپرسد:
"How do I reset my password?"
این سؤال نیز به Embedding تبدیل میشود.
User Question
      ↓
Embedding Model
      ↓
Query Vector
مرحله پنجم: Similarity Search
حالا Query Vector را با Vectorهای موجود در Database مقایسه میکنیم.
سیستم به دنبال Chunkهایی میگردد که از نظر معنایی بیشترین شباهت را با سؤال کاربر دارند.
مثلاً:
Query
  ↓
Vector Search
  ↓
Chunk 17
Chunk 43
Chunk 81
این اطلاعات به عنوان Context در اختیار مدل قرار میگیرند.
مرحله ششم: ارسال Context به LLM
حالا سیستم چیزی شبیه این در اختیار مدل قرار میدهد:
Context:
Users can reset their password from
the Settings > Security section.

Question:
How do I reset my password?
مدل بر اساس Context پاسخ تولید میکند.
مثلاً:
You can reset your password from
Settings > Security.
چرا RAG بهتر از ارسال مستقیم سؤال به LLM است؟
فرض کنید از مدل میپرسیم:
What is our company's refund policy?
مدل اطلاعات داخلی شرکت را نمیداند.
اما با RAG:
Question
   +
Relevant Company Documents
   ↓
LLM
   ↓
Answer
مدل میتواند از اطلاعات اختصاصی شرکت برای تولید پاسخ استفاده کند.
به همین دلیل RAG در سیستمهای سازمانی بسیار کاربردی است.
RAG و Hallucination
یکی از مشکلات LLMها Hallucination است.
یعنی مدل ممکن است پاسخی تولید کند که ظاهراً منطقی است اما واقعیت ندارد.
RAG میتواند با فراهم کردن Context مرتبط، احتمال برخی از این خطاها را کاهش دهد.
اما یک نکته مهم وجود دارد:
RAG به معنی حذف کامل Hallucination نیست.
اگر Retrieval اطلاعات اشتباه یا نامرتبط پیدا کند، مدل نیز ممکن است بر اساس همان Context پاسخ نامناسبی تولید کند.
بنابراین کیفیت Retrieval بخش بسیار مهمی از سیستم RAG است.
RAG چه تفاوتی با Fine-tuning دارد؟
این دو مفهوم خیلی وقتها با یکدیگر اشتباه گرفته میشوند.
RAG
در RAG دانش خارجی هنگام اجرای درخواست به مدل داده میشود.
User
 ↓
Search Knowledge
 ↓
Context
 ↓
LLM
Fine-tuning
در Fine-tuning خود مدل با دادههای آموزشی جدید تنظیم میشود.
به شکل ساده:
Training Data
     ↓
Fine-tuning
     ↓
Updated Model
بنابراین هدف این دو کاملاً یکسان نیست.
اگر هدف شما این است که مدل بتواند به اطلاعاتی که مرتب تغییر میکنند، مثل Documentation یا اطلاعات داخلی شرکت، دسترسی داشته باشد، RAG معمولاً رویکرد متفاوتی نسبت به Fine-tuning دارد.
چه زمانی از RAG استفاده کنیم؟
RAG زمانی مفید است که Application شما نیاز داشته باشد بر اساس اطلاعات خارجی یا اختصاصی پاسخ دهد.
مثلاً:
Chatbot سازمانی
کارمند سؤال میپرسد:
مرخصی سالانه من طبق قوانین شرکت چقدر است؟
سیستم در مستندات داخلی جستجو میکند.
چتبات روی مستندات محصول
کاربر میپرسد:
چطور این دستگاه را Reset کنم؟
سیستم در Manual محصول جستجو میکند.
دستیار برنامهنویسی
Developer میپرسد:
روش Authentication در این پروژه چگونه پیاده شده؟
RAG میتواند در Documentation و Source Code جستجو کند و Context مرتبط را به مدل بدهد.
معماری ساده RAG
یک معماری ساده میتواند چیزی شبیه این باشد:
                ┌──────────────┐
                │   Documents  │
                └──────┬───────┘
                       ↓
                 Chunking
                       ↓
                  Embedding
                       ↓
              ┌─────────────────┐
              │ Vector Database │
              └────────┬────────┘
                       │
                       │
User Question ─────────┘
       ↓
Question Embedding
       ↓
Similarity Search
       ↓
Relevant Context
       ↓
      LLM
       ↓
    Answer
RAG در پروژههای .NET
اگر با ASP.NET Core کار میکنید، میتوانید یک Backend برای سیستم RAG ایجاد کنید.
مثلاً معماری ساده:
ASP.NET Core API
       ↓
RAG Service
       ↓
Embedding Service
       ↓
Vector Database
       ↓
LLM Provider
برای مثال، Endpoint میتواند چیزی شبیه این باشد:
POST /api/chat
Request:
{
  "question": "How can I reset my password?"
}
Backend ابتدا سؤال را دریافت میکند.
سپس:
- سؤال را Embedding میکند.
- Vector Database را جستجو میکند.
- Chunkهای مرتبط را دریافت میکند.
- Prompt را میسازد.
- Prompt + Context را به LLM ارسال میکند.
- پاسخ را به کاربر برمیگرداند.
آیا RAG فقط برای PDF است؟
خیر.
PDF فقط یکی از منابع اطلاعاتی است.
RAG میتواند روی منابع مختلف کار کند، مثل:
PDF
Word
Website
Database
Documentation
Markdown
Source Code
Knowledge Base
Internal Documents
حتی میتوان معماریای طراحی کرد که چند منبع مختلف را همزمان جستجو کند.
چالشهای واقعی RAG
ساختن یک Demo ساده RAG نسبتاً آسان است.
اما ساختن یک RAG خوب برای Production داستان متفاوتی دارد.
چند مسئله مهم عبارتاند از:
کیفیت Chunking
اگر Document به شکل نامناسب تقسیم شود، Retrieval ممکن است Context ناقص دریافت کند.
کیفیت Embedding
Embedding Model روی کیفیت Search تأثیر مستقیم دارد.
کیفیت Retrieval
پیدا کردن Context مناسب یکی از مهمترین بخشهای RAG است.
Context Window
ارسال حجم بسیار زیادی از اطلاعات به LLM همیشه نتیجه بهتری نمیدهد.
هزینه
تعداد Embeddingها، جستجوها و درخواستهای LLM میتواند روی هزینه تأثیر بگذارد.
امنیت
در سیستمهای سازمانی باید دسترسی کاربر به اطلاعات نیز کنترل شود.
مثلاً نباید کارمند واحد A بتواند اطلاعات محرمانه واحد B را از طریق Chatbot دریافت کند.
RAG را خیلی ساده اینطور به خاطر بسپارید
اگر بخواهیم کل مفهوم RAG را در یک جمله خلاصه کنیم:
RAG یعنی قبل از اینکه LLM پاسخ بدهد، اطلاعات مرتبط را از یک منبع خارجی پیدا کنیم و در اختیار مدل قرار دهیم.
فرآیند کلی:
Question
   ↓
Retrieve
   ↓
Relevant Context
   ↓
Generate
   ↓
Answer
و این دقیقاً دلیل نامگذاری آن است:
Retrieval + Augmented + Generation
جمعبندی
RAG یکی از معماریهای مهم برای ساخت Applicationهای مبتنی بر LLM است.
در یک سیستم RAG معمولاً این مراحل را داریم:
Documents
    ↓
Chunking
    ↓
Embedding
    ↓
Vector Database
    ↓
User Query
    ↓
Similarity Search
    ↓
Relevant Context
    ↓
LLM
    ↓
Answer
RAG به ما اجازه میدهد LLM را به اطلاعات اختصاصی و خارجی متصل کنیم، بدون اینکه الزاماً بخواهیم خود مدل را برای هر مجموعه اطلاعات جدید Fine-tune کنیم.
اگر به دنبال ساخت AI Application با .NET و ASP.NET Core هستید، یادگیری RAG یکی از مفاهیم مهمی است که بعد از مباحث پایه LLM، Embedding و Vector Database باید سراغ آن بروید.